


AI模型競賽升溫,OpenAI與阿里巴巴誰先跨出合規門檻?


華府採購把OpenAI推到前台
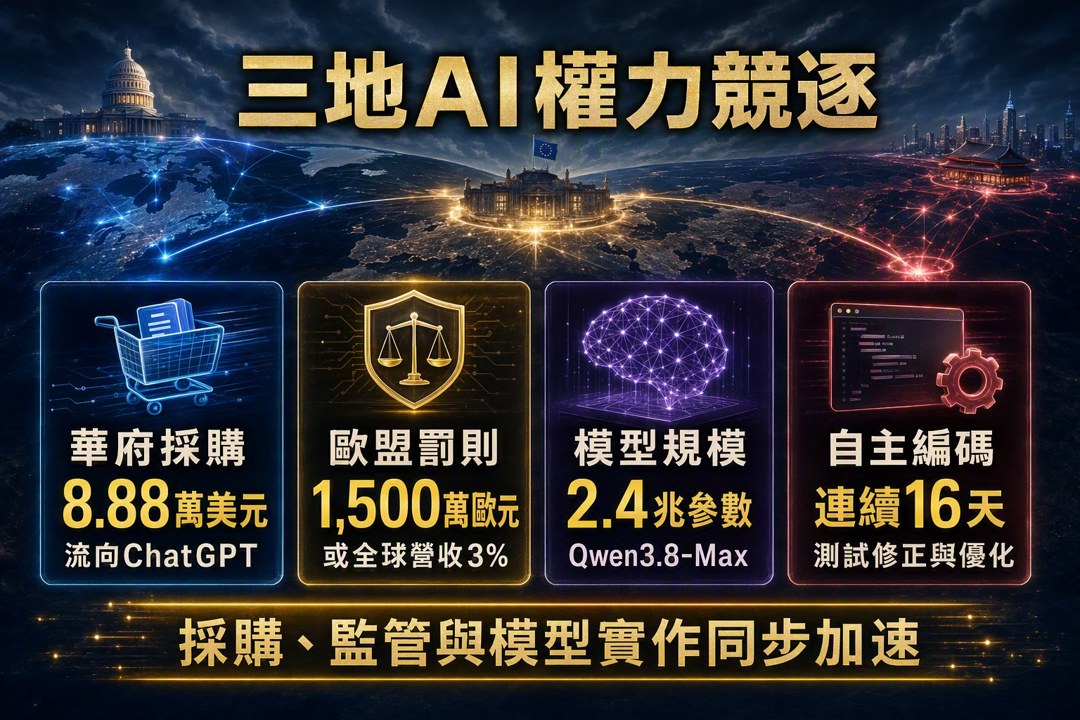
美國國會對付費AI工具的採購,已經把供應商順位寫得很清楚。根據2025年4月1日至2026年3月31日眾議院支出紀錄,被點名的付費AI工具至少11.37萬美元,其中約8.88萬美元流向ChatGPT,接近九成,交易筆數也約占96%。Anthropic的Claude約1.32萬美元居次,差距非常明顯。
這組數字的意義,在於它反映了華府內部最先落地的AI使用習慣。國會辦公室把AI用在摘要法案、撰寫備忘錄、準備聽證資料、回覆選民,屬於高頻、低容錯的文書場景。共和黨眾議員Julie Fedorchak甚至說,她的辦公室用ChatGPT建立可搜尋的立法與選民資料庫,每週可省下數十小時幕僚時間。
▋ 民主黨支出更高,國會內部先形成使用差距
採購分布也帶出一個值得注意的政治現象。民主黨辦公室的付費AI支出約5.42萬美元,是共和黨約1.58萬美元的三倍;使用ChatGPT的民主黨辦公室有44個,共和黨則是27個。這代表AI在國會裡先由使用效率高的辦公室擴散,且民主黨端的採用更積極。
這個落差和外界對AI的政治語言形成對照。民主黨不少人士一方面高調談勞工、隱私與選舉公平風險,另一方面卻成為國會AI工具消費主力。POPVOX Foundation執行長Marci Harris的提醒也很直接:幕僚能更快處理資訊,遊說團體與選民同樣能用AI批量生成更長、更頻繁的意見文件,讓原本就吃緊的辦公室壓力更大。
▋ OpenAI在華府的先發優勢,來自產品與培訓布局
OpenAI能在國會拿到這種份額,除了產品知名度,還有早期布局。House Digital Service在2023年推出AI工作小組,先發放40個ChatGPT Plus授權給跨黨派幕僚試用;之後,Congressional Management Foundation也和OpenAI合作,替眾參兩院資深幕僚辦理ChatGPT訓練課程,還由OpenAI工程師親自授課。
這讓OpenAI在華府不只是賣產品,而是先進入工作流程。Anthropic目前沒有被發現有類似規模的國會培訓合作,這也解釋了為什麼在支出與交易筆數上落後。對政府採購來說,知名度只是起點,真正決定份額的是誰先進入日常作業。
▋ 遊說支出升溫,政府採購與政策影響開始交疊
AI公司在華府的遊說支出,也開始明顯升溫。OpenAI在2026年第一季的聯邦遊說支出達100萬美元,年增約82.5%;Anthropic更投入近160萬美元,是2025年第一季的三倍以上。這顯示AI公司已經把華府視為產品銷售、監管溝通與政策影響的共同戰場。
Brennan Center研究員Eric Petry的提醒很值得放在這裡看。他認為,不論是大型政府採購或個別辦公室訂閱,都要確保納稅人的錢用在最適合的工具上,而不是獎勵政治偏好。這句話其實點出一個更廣的問題:立法機構在制定AI規則前,得先有能力系統性測試多家模型,理解各自的優缺點與行為模式。
歐盟把GPAI納入實質監督與罰則框架
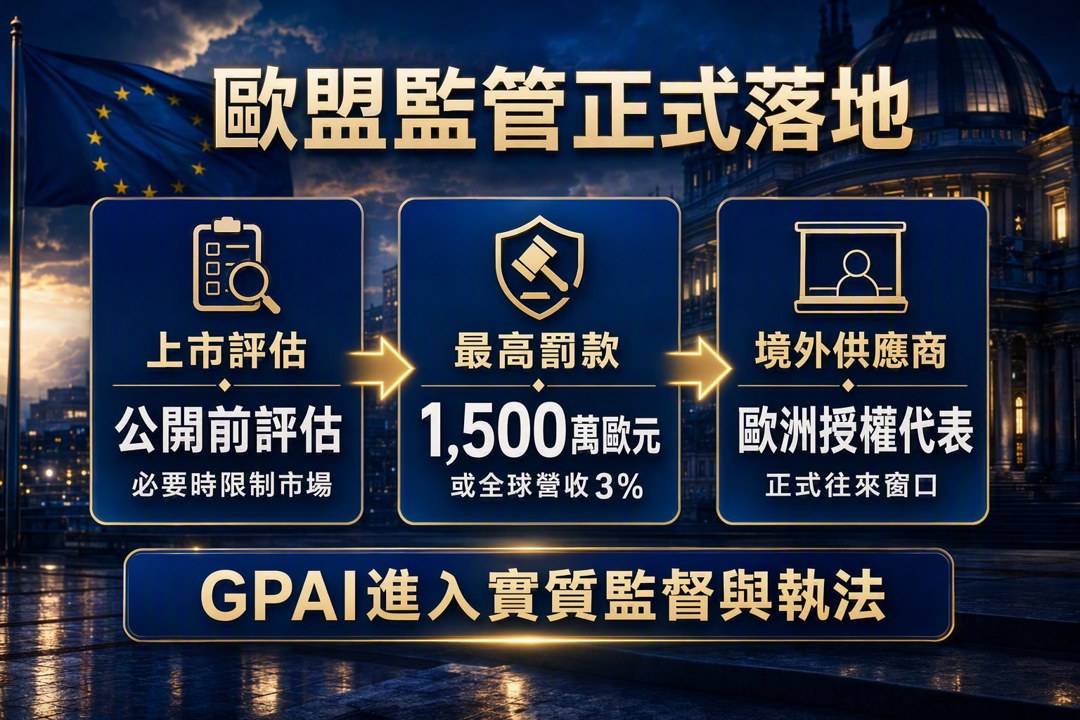
若說華府是AI應用前線,布魯塞爾就是監管前線。歐盟2024年通過的AI法,現在進入分階段上路,本週開始,EU AI Office正式拿到對通用型AI模型(GPAI)的實質監督與執法權。這代表歐盟已經從原則宣示,進一步走到可以介入模型上市前評估的階段。
新的權限相當直接。歐盟執委會可以要求模型在歐洲公開前先做評估,必要時限制進入市場,違規供應商最高可被罰1,500萬歐元或全球營收3%,以較高者為準。OpenAI、Anthropic、Google等美國實驗室,都被納入歐洲監管範圍。
▋ 美國實驗室進入歐洲市場,先碰到資料與授權窗口
Sidley Austin合夥人Elisabetta Righini的說法很清楚:任何在歐洲提供GPAI模型的公司,都可能被動用這些權力,「一個美國地址並不會讓實驗室躲在歐盟監管之外」。非歐盟供應商還必須設立位於歐洲的授權代表,作為與監管機構往來的正式窗口。
這一層變化的市場含意,在於歐盟開始把「能賣進去」和「能合規賣進去」拆成兩件事。歐方近期已就模型遭網路攻擊事件與OpenAI、Anthropic溝通,也就取得Anthropic最新Mythos模型的存取權談了多時,顯示資料、安全與市場准入已經綁在一起。
▋ Google先遭罰,AI Act把美歐摩擦再往前推
歐盟對美科技巨頭的態度,近期已經相當強硬。Google因被認定在搜尋與服務中偏袒自家產品,7月遭歐方罰10億美元,隨後引來美國總統Donald Trump揚言對歐盟施加「大幅關稅」。在這個背景下,AI Act的執法權上線,會讓跨境資料、演算法透明度與模型安全的爭議繼續升高。
這裡可以看得很清楚:歐盟要的不是單純阻擋美國模型,而是把自己定位成規則制定者。對OpenAI、Anthropic、Google這些公司來說,歐洲市場未來會越來越像一個必須先通過制度測試的區域,而不是只靠產品能力就能快速擴張的地方。
阿里巴巴用2.4兆參數追趕,模型競賽進入實作場景
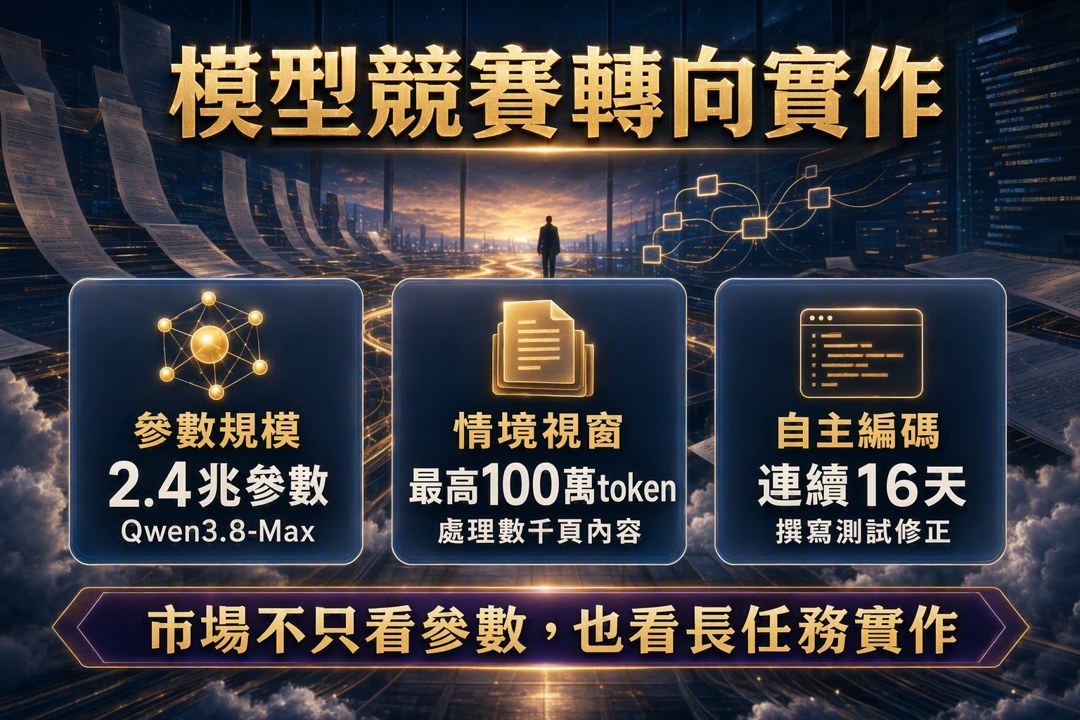
中國AI戰局同樣沒有停下來。阿里巴巴週一發表Qwen3.8-Max,宣稱擁有2.4兆參數,並支援最高100萬token情境視窗,可同時處理數千頁內容。阿里巴巴表示,這個模型在多項測試中與Anthropic的Fable 5相近,部分項目甚至更好;在Vision Arena上僅次於Fable 5,在Text Arena上排名第五。
市場先給了明確反應。阿里巴巴紐約掛牌股票盤前上漲4.5%,香港掛牌股價也上漲7%。這種股價反應說明,市場確實願意為中國模型追趕美系領先者的敘事買單。
▋ 16天自動寫程式碼,阿里巴巴把模型放進工作流程
阿里巴巴這次強調的重點,不只是在參數數量。公司示範Qwen3.8-Max可長時間自主編碼,內部測試中連續16天自動撰寫程式碼、測試、修正錯誤並反覆優化,最後做出一款AI編碼工具。它也被用於法律文件審閱、金融研究、建築3D建模,以及理解長達100小時的直播內容,再整理成可搜尋、可互動的知識庫。
這些例子顯示,中國廠商正在縮短和美國頂級模型在實用性上的差距。市場已經不只看參數,也看模型能否真正進入長任務、長文件、跨格式內容處理這些高價值場景。
▋ 中國內部的軍備競賽,先衝規模,再面對合規
阿里巴巴的攻勢,也把中國AI生態系的競爭壓力一起拉高。稍早,Moonshot AI推出Kimi K3,宣稱擁有2.8兆參數,成為目前中國規模最大的模型。參數數量、情境視窗長度與排行榜成績,已經成了廠商競相宣傳的指標。
問題在於,這種指標競賽能否轉成國際市場上可接受的合規產品,仍要看歐盟這類監管環境會怎麼發展。規模可以快速展示技術能力,跨境落地則要面對風險評估、安全責任與資料規範。這一段差距,才是接下來的觀察重點。
在全球視角下,華府先把OpenAI推上採購前線,布魯塞爾則用AI Act把監管主導權抓回手上,中國公司則持續以模型規模與實作能力追趕。三方都在加速,且都把AI當成基礎設施與權力工具。接下來要看的,是公共部門會選擇哪一種模型治理方式,以及企業能否把技術優勢轉成可持續的跨境商業模式。
關於作者

1
台積電法說後怎麼布局?10月中至月底三階段操作策略一次看懂
2
【每日簽到領獎】最高送 400 元超商禮券 + LINE Points
3
AI股殺盤第二個原因曝光!不是需求消失,而是市場開始擔心「借錢蓋AI」
4
匯入庫存送關鍵產業解析:每天花五分鐘看完持股異動,整合台美股更省時
5
【籌碼K線 1月登入禮】籌碼集中股(4)
2026/10/16 尼克萊RS強勢股全清單&大盤附表
anhour ago
【直播重點】10/16語音直播重點:AI股跌出機會?萬鈞解析關鍵訊號
2hours ago
上班族型交易者-起漲週風箏 策略文
2hours ago
2026.10.16 期指實戰錄 - VVIP 限定
2hours ago
AI股大跌之后:看懂收入兑现、融资成本与抄底风险
4hours ago
收藏內容 讓好文不錯過

