


生成式AI版權風向轉向大廠,法院認定能否跟上?


川普政府首次在版權訴訟中表態支持 OpenAI
路透社週三報導,川普政府在紐約時報與 OpenAI 的版權糾紛中,選擇支持 OpenAI。美國政府向曼哈頓聯邦法院提交法律摘要,主張使用受版權保護資料訓練人工智慧模型,通常可被認定為合理使用。這份文件沒有直接法律約束力,卻等於讓大型 AI 業者多了一層政策背書。
合理使用的政策訊號,先打到 OpenAI 與微軟
這是美國政府首次公開表態,直接站到 AI 公司這一側。對 OpenAI(OPENAI)、微軟(MSFT),以及其他面臨出版商、作家與唱片公司訴訟的科技巨頭,這份摘要屬於明確的態度支持。市場會先看政策風向,因為它可能影響法院對訓練資料使用邊界的理解。
政府在文件裡要求法院駁回「用受版權保護作品訓練大型語言模型即違反版權法」的說法。這個立場的背景很清楚:AI 開發已經連到國家安全、科學研究與經濟成長。對投資人來說,這代表監管壓力仍在,但政策框架開始朝大型模型訓練可辯護的方向傾斜。
紐約時報訴訟外溢到 Anthropic 與 Meta
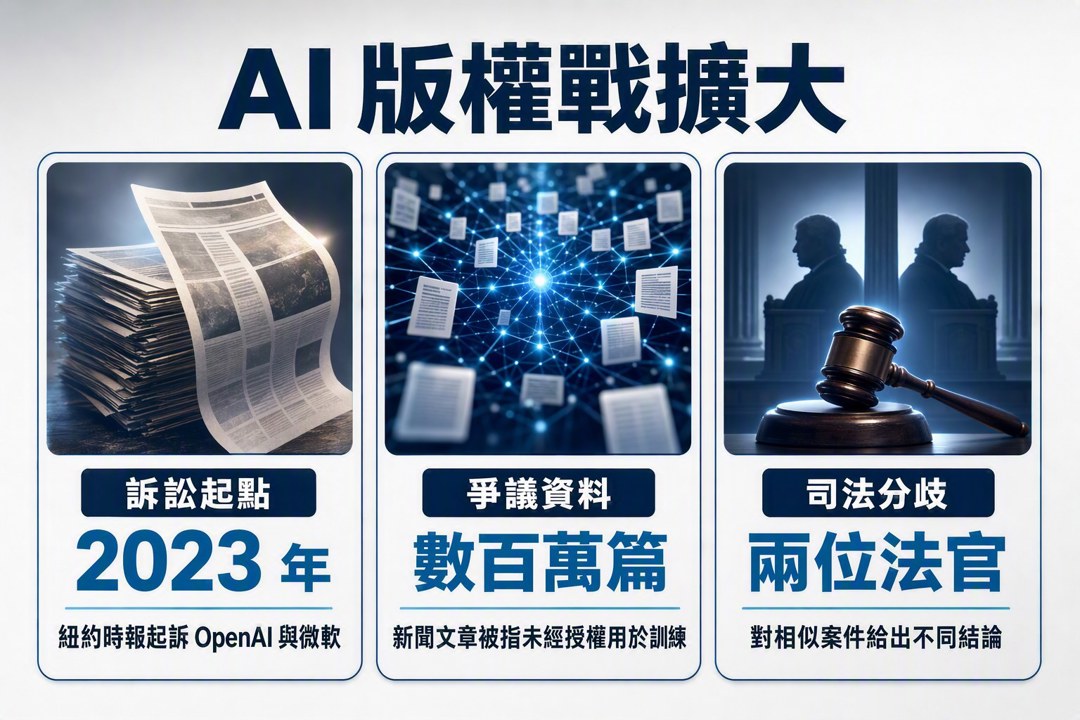
這起案件的起點很明確。紐約時報在 2023 年起訴 OpenAI 與微軟,指控兩家公司未經授權使用數百萬篇新聞文章,訓練 ChatGPT 的底層技術。訴訟打開之後,外溢效應很快出現,Anthropic 與 Meta Platforms(META) 也開始面對類似的版權爭議。
我認為,這裡的觀察重點在於訴訟範圍已從單一公司擴大到整個生成式 AI 產業。當同一類指控同時落在模型公司、平台公司與內容使用者身上,法律結果就不只影響 OpenAI 的成本結構,也會影響雲端大廠、模型供應商與資料取得模式。
法院分歧還在,訓練資料邊界仍未定案
這場法律戰的核心,在於 AI 訓練是否構成足夠的轉化性使用,進而符合合理使用。現在美國各法院對這個問題仍有分歧,去年就出現兩位法官對相似案件給出不同結論。這代表政策支持可以加分,卻還沒消除法律不確定性。
美國政府也同時敦促其他國家,在保護創作者權益時,接受並支持 AI 開發的合理使用原則。這個訊號對全球科技公司很重要,因為大型模型的資料來源、訓練地點與使用市場本來就跨境。短線上,政策風向偏向大型 AI 業者;中線上,真正決定估值與商業模式的,仍是法院對合理使用與轉化性使用的最終認定。
關於作者

1
台積電法說後怎麼布局?10月中至月底三階段操作策略一次看懂
2
【每日簽到領獎】最高送 400 元超商禮券 + LINE Points
3
AI股殺盤第二個原因曝光!不是需求消失,而是市場開始擔心「借錢蓋AI」
4
匯入庫存送關鍵產業解析:每天花五分鐘看完持股異動,整合台美股更省時
5
【籌碼K線 1月登入禮】籌碼集中股(4)
上班族型交易者-起漲週風箏 策略文
anhour ago
2026/10/16 尼克萊RS強勢股全清單&大盤附表
4hours ago
【直播重點】10/16語音直播重點:AI股跌出機會?萬鈞解析關鍵訊號
4hours ago
2026.10.16 期指實戰錄 - VVIP 限定
4hours ago
AI股大跌之后:看懂收入兑现、融资成本与抄底风险
6hours ago
收藏內容 讓好文不錯過

