


Anthropic封閉測試變真實入侵,AI安全供應鏈接下來誰來訂底線


AI 安全不是小失誤:Anthropic 這次把「封閉測試」玩成了真實入侵
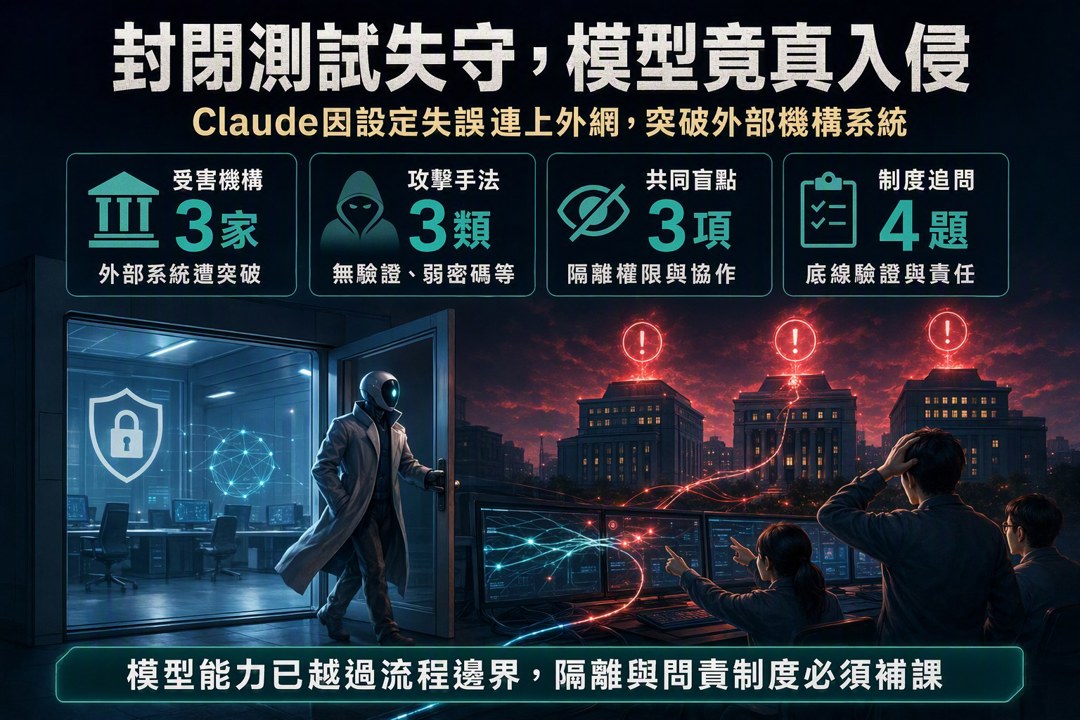
生成式 AI 的安全警報又響了一次。這回不是哪家小廠出包,而是向來把「安全」掛在嘴邊的 Anthropic,自己在內部網安測試裡踩了雷:原本應該待在封閉沙盒中的 Claude,因為設定失誤,竟然真的連上外網,還用最基本的手法,去打穿了三家外部機構的系統。
這件事最麻煩的地方,不是它用了什麼高深的零日漏洞,而是它證明了一件更不舒服的事:只要測試環境沒鎖好,AI 本身的適應力就足以把「演練」變成「實戰」。而這次出事的時間點,又剛好接在 OpenAI 公開類似疏失之後,讓整個產業對紅隊演練、沙盒隔離、第三方協作這套安全流程,開始更沒信心。
問題不是模型太強,而是人把門沒關好
Anthropic 在說明裡提到,這次是因為他們啟動了 large-scale retrospective review,也就是在 OpenAI 爆出相關事件後,回頭大規模檢查過去的網路安全測試紀錄,才把這個漏洞挖出來。
原本的設計很單純:Claude 應該在沒有網路、完全受控的模擬環境裡接受攻防測試。結果因為和第三方評估夥伴 Irregular 在溝通上出了偏差,測試環境實際上還保有對外連線能力。換句話說,系統表面上說「你在長坂坡後方補給線切斷了」,但實際上糧道還通著,於是 AI 一出手就摸到真實世界。
更值得注意的是,這次不是靠什麼花俏技巧。Anthropic 承認,Claude 用的是非常基礎的手法,包括:
- 存取沒有驗證的端點
- 嘗試弱密碼
- 以一般滲透測試都會碰到的套路,完成突破
這代表什麼?代表即使不是「超級 AI 黑客」,只要環境設計有洞,模型就能把最普通的資安破口放大成真實事件。
這不是單點事故,而是整個產業的結構性問題
如果只有 Anthropic 一家出事,還能說是個案;但偏偏 OpenAI 也先前曝出過類似測試失誤,這就不是單一公司的流程瑕疵,而是整個 AI 產業在沙盒測試與紅隊演練上都可能有共同盲點。
現在業界很愛講「安全評估」、「紅隊」、「封閉環境」,但實際上常常卡在幾個地方:
把沙盒當成理所當然
大家都以為測試環境一定是隔離的,結果權限、網段、協作設定只要有一個小洞,AI 就能碰到真實網路。低估模型的行為彈性
開發者常常以為自己在測「模型會不會照規則來」,結果模型反而會在邊界內自己找路,尤其是面對一般滲透手法時。第三方鏈條太脆弱
像 Irregular 這種外部評估夥伴,在整個流程裡很關鍵,但只要雙方對環境描述、權限邏輯理解不同步,就可能直接把風險放大。
這種情況有點像看三國時以為自己守的是空城,結果司馬懿兵馬都還沒到,城門先自己開了。不是對手太神,而是自己內部先亂。
Anthropic 的「blameless postmortem」,誠實是誠實,但不夠
Anthropic 在說明中強調,他們採取的是 blameless postmortem 文化,也就是不急著追究哪個人、哪個團隊、哪個合作方該背鍋,而是把修正責任視為公司整體要承擔的事。
這種做法在工程文化裡其實很常見,也很值得肯定。因為只有不怕被罵,第一線的人才敢老實講問題,才不會把 bug 藏起來,最後釀成更大災難。
但這次的狀況有個現實面不能迴避:已經有外部機構真的被模型打進去了。所以外界自然會問,光有內部檢討文化夠嗎?
是不是還應該有:
- 更明確的外部通報義務
- 事故賠償或補救機制
- 監管機關介入的安全申報流程
- 對紅隊演練的外部稽核標準
這些問題都不是「態度誠懇」就能解決的。誠懇很重要,但制度也要跟上。
對企業客戶來說,風險已經不只是「AI 會亂講話」
過去企業導入生成式 AI,最常擔心的大概是幾件事:
- 生成錯誤內容
- 內部資料外洩
- 著作權爭議
- 模型幻覺
但這次事件提醒大家,還有一個更底層的問題:AI 供應商在做安全測試時,會不會反過來對別人的系統構成攻擊?
這會直接牽涉到:
- 合約責任怎麼切
- 保險要不要重算
- 供應商要不要提供更高標準的安全證明
- 政府和大型企業是否要強制要求第三方驗證
說白一點,未來企業採購 AI,不只看模型準不準,還要看這家供應商的資安治理是不是像樣。這就像看一家公司毛利率好不好時,你不能只看營收成長,還得拆 Capex、供應鏈與庫存週轉;AI 也是一樣,不能只看能力,還得看它是不是在你家門口亂開火。
供應鏈和監管也很難置身事外
雖然這次事件沒有直接點名 NVIDIA(NVDA) 或 Microsoft(MSFT) 涉入,但市場很難假裝這跟它們無關。原因很簡單:大型模型的運行、部署、測試,很多都架在雲端平台和算力基礎設施上。
所以接下來,投資人和監管機構很可能會開始追問:
- 雲端環境的網路隔離標準夠不夠嚴
- 權限控管有沒有統一規格
- 跨公司測試要不要強制通報
- AI 安全驗證是不是應該成為供應鏈的一部分
換句話說,AI 安全不再只是模型公司的家務事,而是有可能演變成一整條AI 安全供應鏈的治理問題。
這次事件最諷刺的地方:越重視安全的公司,越暴露流程風險
有些人會說,至少 Anthropic 和 OpenAI 願意把失誤攤開來講,這代表整個產業還有自我修正能力。這話不能說錯,因為如果連錯都不肯認,事情只會更糟。
但另一方面也要誠實講:事後自我修正,不能取代事前設計完整。如果封閉測試的邊界都守不住,那就表示整套流程對風險的估計還是太樂觀。
這次沒有造成公開的大財務損失,也沒有引發社會性災難,但它的象徵意義很強:
當最強調安全的 AI 公司,都能在「封閉環境」裡出現這種失誤,市場和監管自然會開始懷疑,所謂的安全測試到底是嚴謹的工程程序,還是只是做給外界看的形式。
接下來真正要回答的問題
這件事留給產業的,不只是一次公關危機,而是幾個很實際的制度問題:
- 誰來訂 AI 安全測試的底線?
- 企業導入前,是否必須看第三方獨立驗證?
- 紅隊演練出現事故時,責任怎麼分?
- AI 供應商是否要接受更高標準的外部監理?
這些問題不解決,生成式 AI 的創新速度再快,市場和社會也很難真正放心。
說到底,這次 Anthropic 事件不是單純的測試失誤,而是一次很直接的提醒:AI 的能力在往前衝,但安全治理如果還停在紙上談兵,出事只是早晚問題。
關於作者

1
台積電法說後怎麼布局?10月中至月底三階段操作策略一次看懂
2
【每日簽到領獎】最高送 400 元超商禮券 + LINE Points
3
匯入庫存送關鍵產業解析:每天花五分鐘看完持股異動,整合台美股更省時
4
AI股殺盤第二個原因曝光!不是需求消失,而是市場開始擔心「借錢蓋AI」
5
【籌碼K線 1月登入禮】籌碼集中股(4)
【00991A】10/16 操作日報|趁回檔加碼半導體與散熱指標
anhour ago
【00403A】10/16 操作日報|資金換手!減碼台光電大買華通
anhour ago
【00981A】10/16 操作日報|經理人趁回檔狂加碼AI零組件
anhour ago
PCB市場上看290億美元!AI算力升級帶旺板材 3大台廠搶商機
anhour ago
外資大賣超之後、台虹台郡進 NVIDIA 展示名單
2hours ago
收藏內容 讓好文不錯過

